
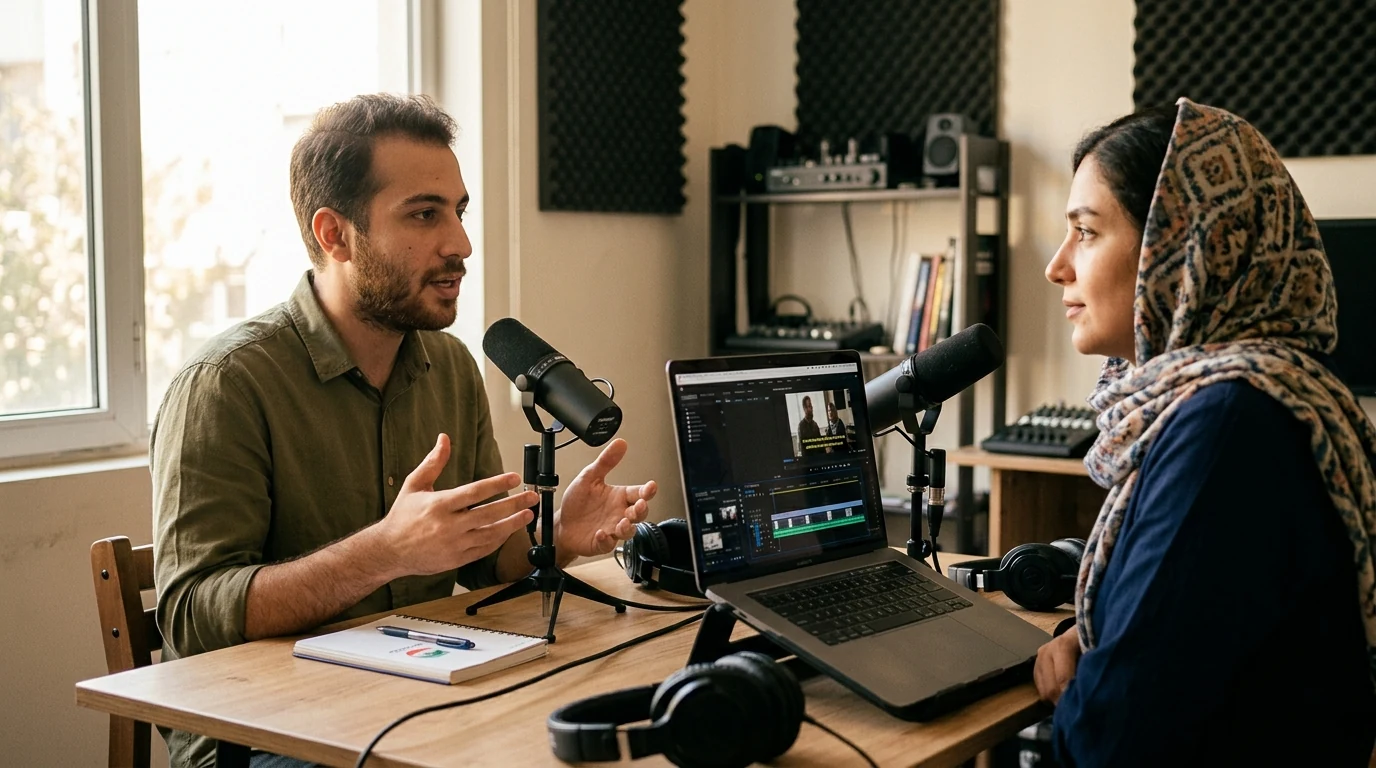
چطور برای ویدیوهای چندنفره زیرنویس درست کنیم؟ تشخیص گوینده و زمانبندی
تولید زیرنویس برای یک ویدیوی تکنفره معمولاً سادهتر است؛ چون تقریباً تمام صحبتها متعلق به یک نفر است. اما وقتی دو یا چند نفر در یک مصاحبه، پادکست، جلسه یا گفتوگو حضور دارند، مسئله فقط تبدیل صدا به متن نیست. باید مشخص باشد چه کسی چه جملهای را گفته و زیرنویس در چه زمانی روی تصویر نمایش داده شود.
اگر این دو بخش درست انجام نشوند، حتی متن کاملاً صحیح هم میتواند برای مخاطب گیجکننده باشد. به همین دلیل، زیرنویس ویدیوهای چندنفره نیاز به یک مرحله بررسی بیشتر دارد.
چرا زیرنویس ویدیوی چندنفره سختتر است؟
در یک ویدیوی تکنفره، سیستم تشخیص گفتار معمولاً با یک صدای اصلی سروکار دارد. اما در مصاحبه یا گفتوگوی چندنفره، صداها ممکن است بهصورت پشت سر هم یا حتی گاهی با فاصله بسیار کم وارد فایل شوند.
تفاوت در سرعت صحبت، بلندی صدا، لهجه، نویز محیط و همپوشانی صحبتها نیز میتواند فرآیند تبدیل گفتار به متن را پیچیدهتر کند.
بنابراین برای ویدیوی چندنفره باید علاوه بر دقت متن، به تشخیص گوینده و زمانبندی نیز توجه کرد.
تشخیص گوینده در زیرنویس یعنی چه؟
تشخیص گوینده یعنی مشخص شود هر بخش از گفتوگو متعلق به کدام فرد است. برای مثال، در یک مصاحبه ممکن است یک نفر سؤال بپرسد و فرد دیگری پاسخ دهد.
اگر متن پاسخ به اشتباه به گوینده اول نسبت داده شود، مخاطب ممکن است حتی با وجود درست بودن کلمات، ساختار گفتوگو را اشتباه متوجه شود.
در بعضی پروژهها میتوان گویندهها را با نام مشخص کرد و در بعضی دیگر، تفاوت آنها از طریق طراحی یا جایگاه زیرنویس مشخص میشود. روش مناسب به نوع محتوا و پلتفرم انتشار بستگی دارد.
آیا زیرنویس خودکار میتواند چند گوینده را تشخیص دهد؟
ابزارهای تشخیص گفتار میتوانند در برخی شرایط به تفکیک بخشهای گفتاری کمک کنند، اما نباید تصور کرد که هر خروجی خودکار بدون بررسی انسانی برای انتشار آماده است.
کیفیت میکروفون، فاصله افراد از میکروفون، صدای پسزمینه، تعداد گویندهها و میزان همپوشانی صحبتها روی نتیجه تأثیر میگذارند.
به همین دلیل، بهتر است خروجی خودکار را نسخه اولیه زیرنویس بدانیم و بعد آن را از نظر متن، گوینده و زمانبندی بررسی کنیم.
اگر دو نفر همزمان صحبت کنند چه میشود؟
یکی از سختترین حالتها زمانی است که دو نفر تقریباً همزمان صحبت میکنند. در این شرایط، حتی برای انسان نیز تشخیص دقیق کلمات ممکن است دشوار باشد؛ مخصوصاً اگر صداها روی هم قرار بگیرند یا یکی از میکروفونها صدای واضحی نداشته باشد.
در چنین شرایطی ابتدا باید مشخص شود آیا هر دو صحبت واقعاً برای مخاطب قابل استفاده هستند یا بخشی از آنها در تدوین باید حذف شود.
اگر هر دو بخش مهم باشند، زیرنویس باید به شکلی تنظیم شود که مخاطب بتواند ارتباط بین صدا و متن را دنبال کند، بدون اینکه چند جمله طولانی بهصورت همزمان روی صفحه قرار بگیرد.
زمانبندی زیرنویس در گفتوگوی چندنفره
زمانبندی در ویدیوی چندنفره اهمیت زیادی دارد؛ چون تغییر گوینده معمولاً همراه با تغییر محتوای جمله نیز اتفاق میافتد.
اگر زیرنویس نفر اول بعد از شروع صحبت نفر دوم همچنان روی تصویر بماند، مخاطب ممکن است تصور کند جمله جدید نیز متعلق به همان فرد است.
بنابراین باید شروع و پایان هر بخش زیرنویس با صحبت واقعی گوینده هماهنگ باشد.
هر جمله را چه زمانی روی تصویر نمایش دهیم؟
قرار نیست هر جمله دقیقاً با یک قانون ثابت روی تصویر ظاهر شود. زمان نمایش باید با طول جمله، سرعت صحبت و ساختار گفتوگو هماهنگ باشد.
اگر یک جمله بسیار کوتاه است، نمایش طولانی آن میتواند ریتم ویدیو را خراب کند. از طرف دیگر، اگر جمله طولانی باشد و خیلی سریع ناپدید شود، مخاطب فرصت خواندن آن را نخواهد داشت.
برای همین، خوانایی باید همراه با زمانبندی بررسی شود، نه اینکه این دو مرحله کاملاً جدا از هم در نظر گرفته شوند.
آیا باید نام گوینده را داخل زیرنویس بنویسیم؟
همیشه لازم نیست. اگر تصویر بهوضوح نشان میدهد چه کسی صحبت میکند، ممکن است نیازی به اضافه کردن نام وجود نداشته باشد.
اما در پادکست، مصاحبه صوتی، ویدیوهایی با قاب ثابت یا صحنههایی که چند نفر همزمان در تصویر هستند، مشخص کردن گوینده میتواند به فهم بهتر گفتوگو کمک کند.
مهم این است که این روش به شکل ثابت در کل ویدیو اجرا شود. اگر یک بار گوینده با نام مشخص شود و چند دقیقه بعد بدون هیچ الگوی مشخصی تغییر کند، تجربه مخاطب نامنظم خواهد شد.
برای پادکستهای تصویری چه روشی بهتر است؟
پادکستهای تصویری معمولاً از نمونههای رایج محتوای چندنفره هستند. ممکن است دو مجری، مجری و مهمان یا چند مهمان در یک قسمت حضور داشته باشند.
در این محتوا بهتر است ابتدا ساختار گفتوگو مشخص شود و سپس زیرنویس بر اساس آن تنظیم شود.
- گویندههای اصلی را مشخص کنید.
- تغییر گوینده را بررسی کنید.
- جملهها را در نقاط مناسب تقسیم کنید.
- زمانبندی متن را با صدا هماهنگ کنید.
- اصطلاحات و اسامی خاص را بازبینی کنید.
- در صورت نیاز، روش مشخصی برای تفکیک گویندهها انتخاب کنید.
زیرنویس مصاحبه چه نکتهای دارد؟
در مصاحبه، سؤال و جواب معمولاً ساختار مشخصی دارد. اگر زیرنویس این ساختار را بهخوبی منتقل نکند، مخاطب ممکن است در تشخیص سؤال و پاسخ دچار مشکل شود.
در ویدیوهایی که دوربین بین مصاحبهکننده و مهمان جابهجا میشود، تصویر میتواند به تشخیص گوینده کمک کند. اما اگر قاب ثابت باشد یا از تصاویر مکمل استفاده شود، طراحی و زمانبندی زیرنویس اهمیت بیشتری پیدا میکند.
چرا نباید تمام گفتوگو را یکجا زیرنویس کنیم؟
یکی از اشتباهات رایج این است که بخش بزرگی از گفتوگو به شکل چند خط طولانی روی تصویر قرار بگیرد.
این روش بهخصوص در ویدیوهای چندنفره مشکلساز است، چون مخاطب باید همزمان گوینده، تصویر و متن را دنبال کند.
بهتر است متن به بخشهای کوتاهتر و منطقی تقسیم شود و هر بخش در زمان مناسب نمایش داده شود.
نقش کیفیت صدا در تشخیص گوینده
کیفیت فایل صوتی یکی از عوامل مهم در نتیجه زیرنویس خودکار است. اگر صدای افراد واضح باشد و نویز محیط کم باشد، احتمال رسیدن به متن قابل استفاده بیشتر میشود.
اگر چند نفر با یک میکروفون دور از خود صحبت کنند، صدای محیط زیاد باشد یا افراد مرتب روی صحبت یکدیگر وارد شوند، احتمال خطا بیشتر خواهد شد.
بنابراین بخشی از کیفیت زیرنویس قبل از شروع زیرنویسگذاری و در مرحله ضبط صدا تعیین میشود.
یک workflow مناسب برای زیرنویس ویدیوهای چندنفره
برای پروژههای چندنفره میتوان فرآیند زیر را در نظر گرفت:
- آمادهسازی فایل: نسخه نهایی ویدیو را برای زیرنویس آماده کنید.
- تولید متن اولیه: از تبدیل خودکار گفتار به متن برای ایجاد نسخه اولیه استفاده کنید.
- بررسی گوینده: مشخص کنید هر بخش متعلق به کدام فرد است.
- اصلاح متن: اشتباهات تشخیص کلمات، اسامی و اصطلاحات را اصلاح کنید.
- تنظیم زمانبندی: شروع و پایان هر بخش را با صحبت واقعی هماهنگ کنید.
- تقسیم جملات: متنهای طولانی را به بخشهای خواناتر تقسیم کنید.
- بررسی تصویری: ویدیو را کامل ببینید و ارتباط متن با تصویر و گوینده را بررسی کنید.
- خروجی نهایی: فایل زیرنویس یا ویدیوی زیرنویسشده را طبق نیاز پروژه آماده کنید.
کپزو در زیرنویس ویدیوهای چندنفره چه نقشی دارد؟
وقتی تعداد مصاحبهها، پادکستها یا ویدیوهای گفتوگومحور زیاد میشود، تایپ دستی متن و تنظیم اولیه زیرنویس برای هر فایل میتواند زمان زیادی از تیم محتوا بگیرد.
کپزو میتواند در مرحله تولید اولیه زیرنویس به سریعتر شدن این فرآیند کمک کند. بعد از تولید خروجی اولیه، تیم میتواند روی بررسی موارد مهمتر مثل تشخیص درست گوینده، اصطلاحات تخصصی و زمانبندی تمرکز کند.
این رویکرد بهجای اینکه کل فرآیند را به شکل دستی انجام دهید، بخشی از کار تکراری را سریعتر میکند و زمان انسان را برای کنترل کیفیت نهایی نگه میدارد.
چطور خطاهای زیرنویس چندنفره را کمتر کنیم؟
اگر ویدیوهای زیادی تولید میکنید، داشتن یک روش ثابت برای بررسی زیرنویس میتواند کمک زیادی کند.
- نام یا شناسه گویندههای اصلی را از ابتدا مشخص کنید.
- قبل از زیرنویس، تدوین نهایی ویدیو را انجام دهید.
- صدای هر گوینده را در خروجی بررسی کنید.
- تغییر گوینده را در متن و زمانبندی کنترل کنید.
- اصطلاحات تخصصی و نامها را بازبینی کنید.
- بخشهای دارای صحبت همزمان را جداگانه بررسی کنید.
- بعد از هر تغییر اساسی در تدوین، زمانبندی زیرنویس را دوباره کنترل کنید.
آیا برای همه ویدیوهای چندنفره باید زیرنویس دستی تولید کرد؟
نه. روش مناسب به کیفیت فایل و حساسیت پروژه بستگی دارد.
برای یک ویدیوی ساده با دو گوینده و صدای واضح، تولید خودکار نسخه اولیه میتواند بخش قابل توجهی از کار را سریعتر کند. اما در یک مصاحبه تخصصی با اصطلاحات زیاد، چند گوینده و صحبتهای همزمان، بازبینی دقیق اهمیت بیشتری پیدا میکند.
بنابراین بهتر است به جای انتخاب مطلق بین «کاملاً دستی» و «کاملاً خودکار»، یک فرآیند ترکیبی داشته باشید: تولید سریع نسخه اولیه + بررسی انسانی + اصلاح نهایی.
چکلیست زیرنویس ویدیوی چندنفره
- آیا متن صحبتها درست تشخیص داده شده است؟
- آیا مشخص است هر بخش را چه کسی گفته است؟
- آیا زمان شروع و پایان زیرنویس با صدا هماهنگ است؟
- آیا تغییر گوینده بهوضوح قابل تشخیص است؟
- آیا جملهها بیش از حد طولانی نیستند؟
- آیا نامها و اصطلاحات تخصصی بررسی شدهاند؟
- آیا بخشهای دارای صحبت همزمان بازبینی شدهاند؟
- آیا زیرنویس روی بخش مهم تصویر قرار نگرفته است؟
- آیا خروجی نهایی بعد از آخرین تغییرات تدوین بررسی شده است؟
جمعبندی
زیرنویس ویدیوهای چندنفره فقط به تبدیل صدا به متن محدود نمیشود. تشخیص گوینده، زمانبندی، تقسیم جملات و بازبینی متن همگی برای ساخت یک زیرنویس قابل دنبال کردن اهمیت دارند.
هرچه تعداد گویندهها بیشتر، کیفیت صدا پایینتر و میزان همپوشانی صحبتها بیشتر باشد، نیاز به بررسی انسانی نیز بیشتر میشود.
برای تولید تعداد زیادی ویدیوی مصاحبه، پادکست یا گفتوگو، میتوان با استفاده از زیرنویس خودکار مرحله اولیه تولید متن را سریعتر کرد و سپس زمان تیم را روی تشخیص گوینده، اصلاح خطاها و کنترل نهایی گذاشت.
اگر بهصورت منظم ویدیوهای چندنفره تولید میکنید، کپزو میتواند یکی از ابزارهای مرحله تولید اولیه زیرنویس در workflow شما باشد؛ مخصوصاً زمانی که هدف، کاهش کار تکراری و تمرکز بیشتر روی کنترل کیفیت نهایی است.
سؤالات متداول
آیا زیرنویس خودکار میتواند گویندهها را از هم تشخیص دهد؟
بسته به ابزار و کیفیت فایل، امکان تفکیک بخشهای گفتاری وجود دارد، اما نتیجه همیشه بدون خطا نیست و بهتر است تغییر گوینده و متن نهایی بررسی شود.
اگر دو نفر همزمان صحبت کنند چه کنیم؟
ابتدا مشخص کنید کدام بخش برای مخاطب قابل استفاده و مهم است. سپس بخشهای همزمان را با دقت بیشتری بررسی کنید و از قرار دادن حجم زیادی از متن روی صفحه در یک لحظه خودداری کنید.
برای پادکست چندنفره زیرنویس لازم است؟
اجباری نیست، اما زیرنویس میتواند دسترسی و دنبال کردن گفتوگو را برای مخاطبانی که بدون صدا یا در محیطهای مختلف ویدیو را میبینند سادهتر کند.
آیا نام گوینده را باید در زیرنویس بنویسیم؟
نه همیشه. اگر تصویر گوینده را بهوضوح نشان میدهد ممکن است نیازی نباشد، اما در قابهای ثابت یا گفتوگوهای پیچیده، مشخص کردن گوینده میتواند به فهم بهتر کمک کند.
چطور زمان تولید زیرنویس چندنفره را کاهش دهیم؟
میتوان نسخه اولیه زیرنویس را بهصورت خودکار تولید کرد و سپس زمان را صرف بررسی گویندهها، اصطلاحات، زمانبندی و خطاهای مهم کرد. این روش معمولاً از تایپ و زمانبندی کامل بهصورت دستی کمکارتر است.